
Статья 4 цикла «AI-агенты в техническом SEO: от MCP-серверов до автоматизации аудита». Статья 3 дала нормализованные данные (таблица
page, снимки, вектор). Здесь агент впервые на них «думает»: превращает сырое состояние сайта в приоритизированный список проблем с объяснениями и предложенными исправлениями — то, что SEO-специалист обычно делает руками.
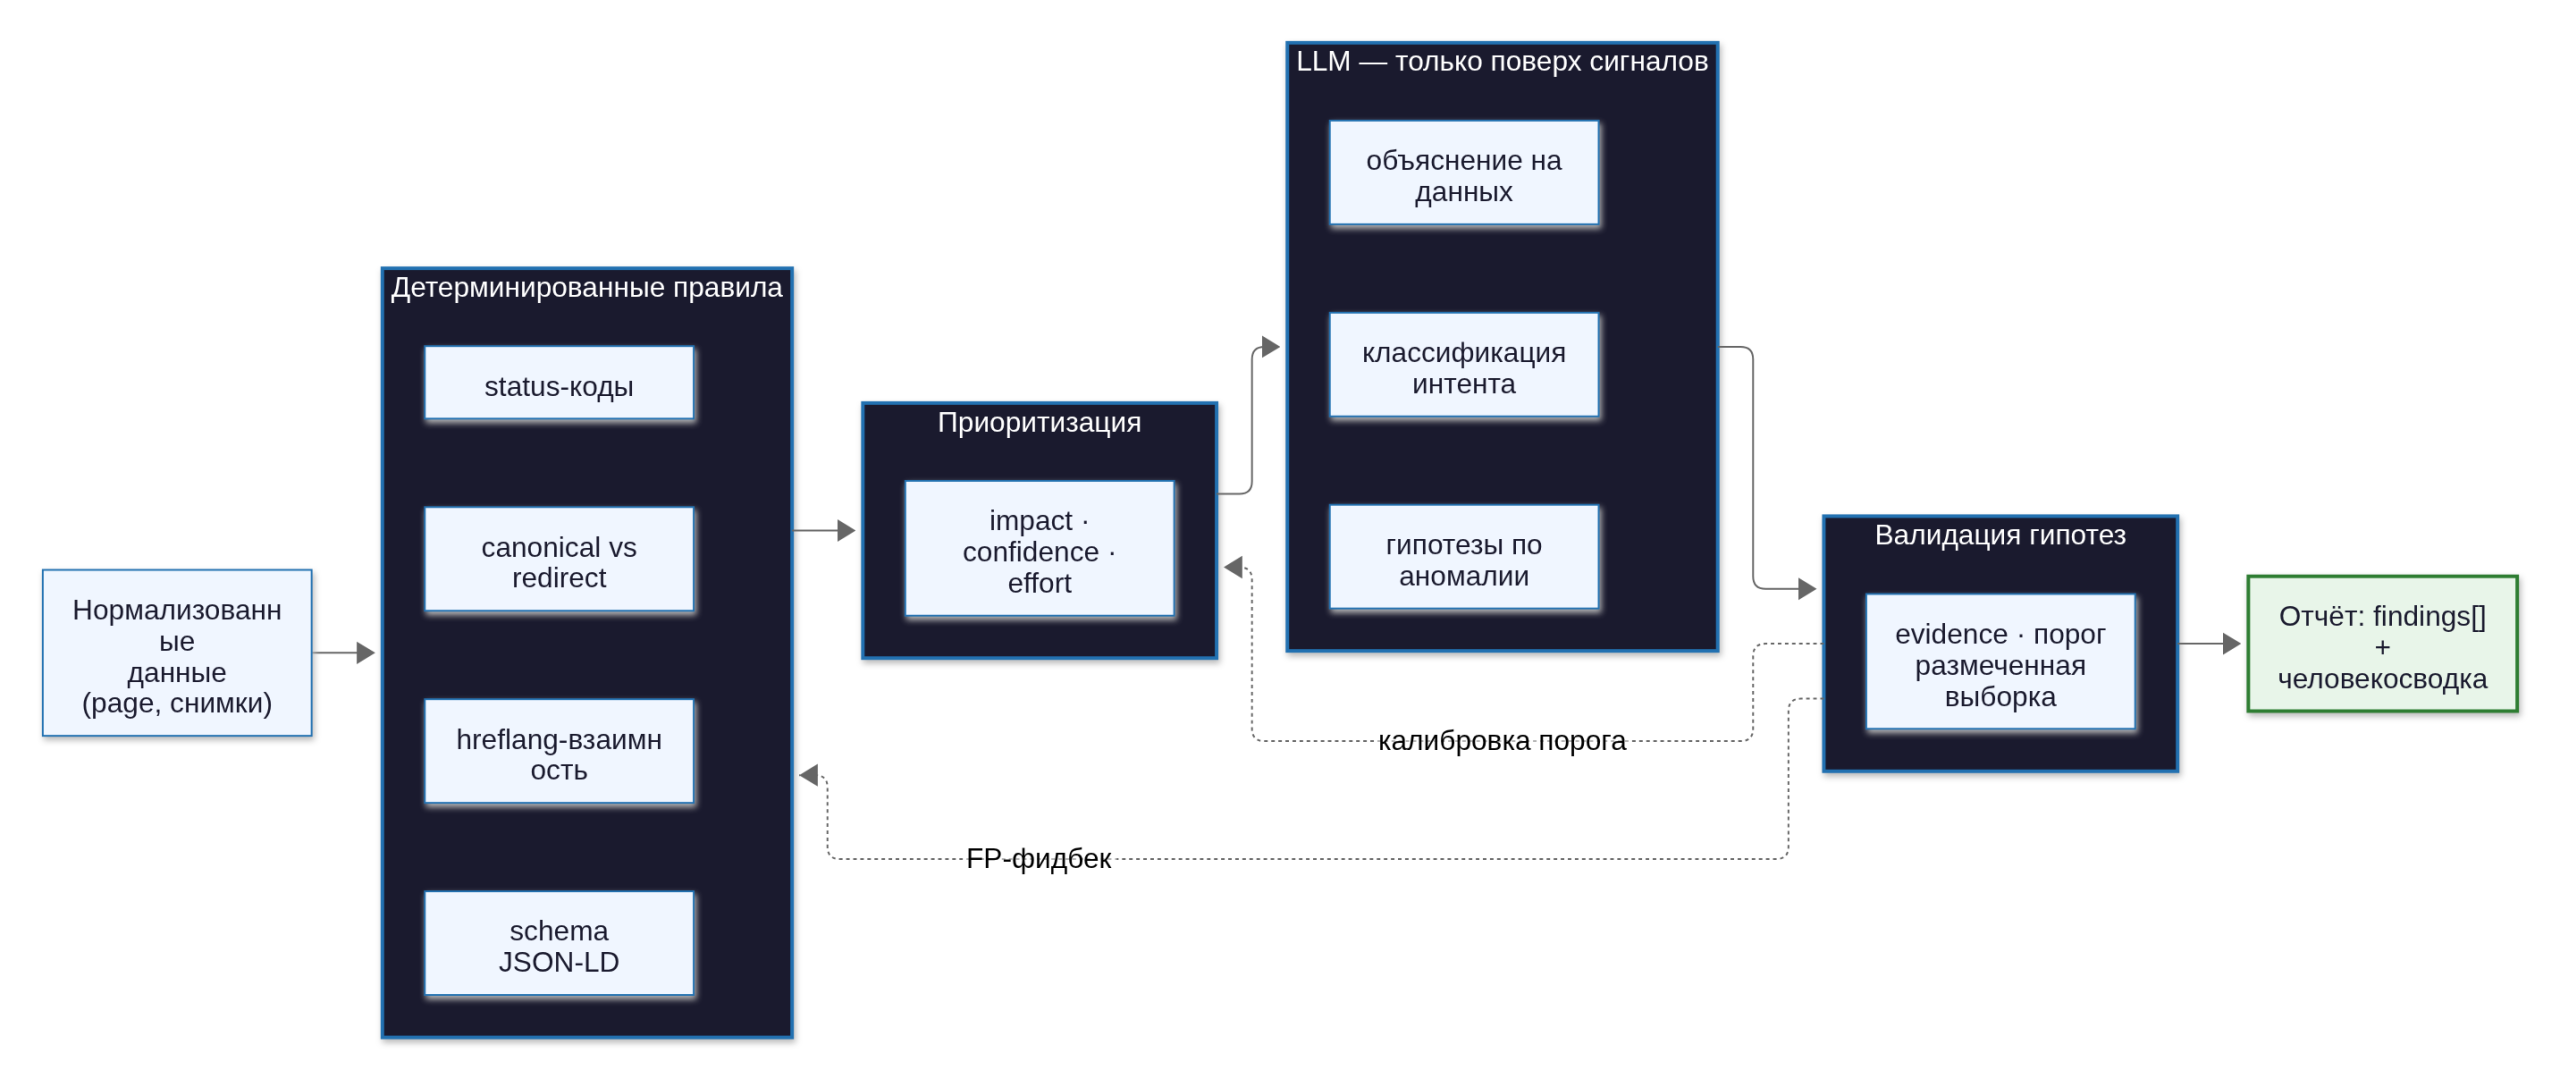
Соблазн на этом слое — скормить всё модели и попросить: «найди проблемы на сайте». Получите список правдоподобных догадок, половина из которых ложная, без единого доказательства. Правильная архитектура обратная: сначала дешёвые детерминированные правила, LLM — только там, где правило не выражается, и поверх сигналов, а не вместо них. Разберём этот гибрид по частям. Цикл агента тех. аудита: правила → приоритизация → LLM → валидация:
1. Гибридный подход: где правило, где модель
Разделительная линия проходит по одному критерию — есть ли у проверки дешёвый бинарный инвариант.
Там, где инвариант есть, правит код. Каноникол обязан совпадать с фактическим редиректом; hreflang-аннотации обязаны быть взаимными; страница с noindex не может одновременно быть в sitemap; JSON-LD обязан парситься и соответствовать схеме. Это детерминировано, воспроизводимо и стоит нуль токенов. Правило на 50 000 URL работает секунды и даёт один и тот же ответ каждый прогон.
Там, где инварианта нет, правит модель. «Какой интент у этой посадочной», «почему у этой группы страниц показы падают, а клики нет», «сформулируй гипотезу по аномалии» — это не выражается if. Здесь LLM незаменим. Но он вызывается точечно: только на страницах, которые правила уже пометили как аномальные, и только на доказательствах, которые дали правила и данные.
Практическое правило, которое держит гибрид под контролем: правила генерируют сигналы, модель интерпретирует сигналы. Модель никогда не решает «есть ли проблема» с нуля — она решает «что эта помеченная проблема значит и как её объяснить». Это резко режет галлюцинации: нечего выдумывать, когда вход — уже размеченный факт.
2. Набор правил-валидаторов
Ниже — ядро reasoning-слоя, пять валидаторов с кодом. Каждый принимает нормализованную страницу (результат статьи 3) и возвращает находку или ничего. Формат единый, чтобы приоритизация дальше работала со списком одинаковых объектов.
from dataclasses import dataclass, field

@dataclass
class Finding:
    rule: str
    page_id: int
    severity: str          # 'high' | 'medium' | 'low'
    evidence: dict         # голые факты — то, на чём стоит вывод
    urls: list = field(default_factory=list)

def check_canonical_vs_redirect(p) -> Finding | None:
    """Canonical указывает на URL, который сам редиректит — битая цепочка.
    Инвариант: canonical-цель должна отдавать 200, а не 301/302."""
    if p.canonical and p.canonical_status in (301, 302, 307, 308):
        return Finding("canonical_to_redirect", p.page_id, "high",
                       {"canonical": p.canonical, "canonical_status": p.canonical_status})

def check_hreflang_reciprocity(p, index) -> Finding | None:
    """hreflang обязан быть взаимным: если /de ссылается на /en, /en должен
    ссылаться обратно на /de. Одиночная стрелка = аннотация не работает."""
    for lang, target in (p.hreflang or {}).items():
        back = index.hreflang_targets(target)
        if p.canonical_url not in back:
            return Finding("hreflang_not_reciprocal", p.page_id, "medium",
                           {"lang": lang, "target": target, "missing_backlink_to": p.canonical_url})

def check_noindex_in_sitemap(p, sitemap_urls) -> Finding | None:
    """Страница в sitemap, но с noindex — противоречие: просим проиндексировать
    то, что явно запретили."""
    if p.noindex and p.canonical_url in sitemap_urls:
        return Finding("noindex_in_sitemap", p.page_id, "high",
                       {"noindex": True, "in_sitemap": True})

def check_status_vs_indexability(p) -> Finding | None:
    """Индексируемая страница отдаёт не-200 (4xx/5xx), но GSC её показывает —
    Google держит в индексе мёртвый URL."""
    if p.is_indexed and p.status_code >= 400:
        return Finding("indexed_but_error", p.page_id, "high",
                       {"status_code": p.status_code, "is_indexed": True})

def check_schema_parses(p) -> Finding | None:
    """JSON-LD не парсится или не проходит базовую схему — rich result не засчитается."""
    if p.jsonld_raw and not p.jsonld_valid:
        return Finding("schema_invalid", p.page_id, "medium",
                       {"jsonld_error": p.jsonld_error, "types": p.jsonld_types})

VALIDATORS = [
    check_canonical_vs_redirect, check_hreflang_reciprocity,
    check_noindex_in_sitemap, check_status_vs_indexability, check_schema_parses,
]

def run_rules(pages, index, sitemap_urls) -> list[Finding]:
    out = []
    for p in pages:
        for v in VALIDATORS:
            f = v(p, index, sitemap_urls) if v.__code__.co_argcount == 3 else (v(p, index) or v(p, sitemap_urls))
            if f:
                out.append(f)
    return out
(В диспетчере run_rules намеренно оставлен простой разбор арности — в реальном коде передавайте зависимости явно через контекст, а не через inspect; здесь это сжато ради читаемости.)
Заметьте: каждый валидатор возвращает evidence — голые факты, на которых стоит вывод. Это не украшение. Именно evidence потом идёт в LLM как единственный разрешённый источник для объяснения, и именно по нему человек проверяет, не наврал ли агент. Это тот же принцип, что в проверке ссылок: вывод обязан ссылаться на полученное доказательство, а не на знание модели.
3. Приоритизация: impact × confidence × effort
Правила дали список находок. На 50 000 страниц их будут тысячи, и «все критичные сразу» — не приоритизация, а отказ приоритизировать. Правильная формула — произведение трёх независимых осей:
- impact — сколько трафика/индекса затронуто. Берём из данных: сумма кликов/показов
pageиз GSC (статья 3). Проблема на странице с 10 000 показов важнее той же на нулевой. - confidence — насколько мы уверены, что это реально проблема. У детерминированных правил confidence ≈ 1.0 (инвариант либо нарушен, либо нет). У LLM-гипотез confidence ниже и задаётся моделью честно, по шкале.
- effort — цена исправления, от 0 (одна директива) до 1 (переписать раздел сайта). Чем дороже, тем ниже приоритет при равных прочих.
def score(f: Finding, page) -> float:
    impact = normalize_traffic(page.clicks, page.impressions)   # 0..1
    confidence = f.evidence.get("confidence", 1.0)              # правило -> 1.0
    effort = EFFORT_BY_RULE[f.rule]                             # таблица 0..1
    return round(impact * confidence / (0.3 + effort), 4)       # делим, не умножаем: effort — знаменатель

def triage(findings, pages_by_id, top=50) -> list:
    scored = [(score(f, pages_by_id[f.page_id]), f) for f in findings]
    return sorted(scored, key=lambda x: x[0], reverse=True)[:top]
effort в знаменателе — принципиально: дорогое исправление не обнуляет приоритет, а снижает его. Плюс 0.3, чтобы не делить на ноль и не убивать дешёвые правки совсем. Порядок получается «много трафика, уверенно, дешёво» наверху — ровно то, что человек реально делает первым.
4. Как заставить агента объяснять
Приоритизированный список бесполезен, если его некому прочитать. Здесь подключается LLM — но строго в трёх ролях, и каждая получает evidence как единственный источник фактов.
Классификация интента. Правила не знают, «коммерческая» это страница или «информационная», а от этого зависит, важна ли найденная проблема. Модель классифицирует по тексту страницы (из снимка), не по URL-угадыванию.
Гипотезы по аномалии. Когда показы падают, а клики стоят, правило бессильно. Модель получает числа (временной ряд из GSC) и что изменилось (разницу снимков краулера) и предлагает гипотезу. Ключевое: гипотеза обязана ссылаться на переданные числа.
Объяснение находки. Для каждой находки из §2 модель пишет человеку: почему это важно, какие URL затронуты, какой ожидаемый эффект. Модель не решает, есть ли проблема (это сделал инвариант), она переводит факт в понятную форму.
Промпт-схема для этих ролей. Формат JSON со схемой — ровно тот же приём, что в вашем каркасе аудитора, где модель обязана вернуть priority/title/detail: жёсткая схема не даёт модели «разойтись» в свободный текст.
EXPLAIN_PROMPT = """
Ты объясняешь одну находку технического аудита SEO-специалисту.
РАЗРЕШЕНО опираться ТОЛЬКО на блок EVIDENCE. Если факта нет в EVIDENCE —
не выдумывай, верни null в соответствующем поле.

EVIDENCE:
{evidence_json}

ДАННЫЕ СТРАНИЦЫ (только для формулировки, не для новых диагнозов):
{page_facts_json}

Верни СТРОГО JSON по схеме:
{{
  "why_matters": "1-2 предложения, почему это важно для этой страницы",
  "affected_urls": ["список URL из EVIDENCE"],
  "expected_effect": "что улучшится после исправления, без чисел которых нет в EVIDENCE",
  "confidence": 0.0-1.0
}}
Никакого текста вне JSON.
"""
Три guardrail’а прямо в промпте, и все три работают: «только EVIDENCE» отсекает галлюцинации, «верни null» вместо догадки даёт машине распознать неуверенность, «никакого текста вне JSON» делает вывод парсимым. Confidence, которое модель возвращает, идёт обратно в формулу §3 — так объяснение и приоритет не расходятся.
5. Валидация гипотез: не утонуть в ложных срабатываниях
Гибрид без валидации деградирует в генератор шума. Механизм один: размеченная выборка + precision/recall, и обратная связь в правила.
Берёте 200–500 страниц, которые человек вручную разметил («тут реально есть проблема X», «тут нет»). Прогоняете агент и считаете:
def prf(findings, labeled) -> dict:
    """labeled: {page_id: expected_rule}. TP — правило сработало и проблема есть;
    FP — сработало, а проблемы нет; FN — молчало, а проблема была."""
    tp = sum(1 for f in findings if labeled.get(f.page_id) == f.rule)
    fp = sum(1 for f in findings if labeled.get(f.page_id) != f.rule)
    fn = sum(1 for pid, r in labeled.items() if not any(f.page_id == pid and f.rule == r for f in findings))
    p = tp / (tp + fp) if (tp + fp) else 0.0
    r = tp / (tp + fn) if (tp + fn) else 0.0
    return {"precision": round(p, 3), "recall": round(r, 3),
            "f1": round(2*p*r/(p+r), 3) if (p+r) else 0.0}
Что делать с числами — и это главное отличие агента от «промпт-обёртки»:
- Низкий precision по правилу → правило слишком широкое, оно генерирует FP. Фикс — сузить инвариант в коде валидатора, а не «попросить модель быть аккуратнее». FP-фидбек идёт обратно в слой правил (пунктир на схеме).
- Низкий recall → правила слепые, пропускают реальные проблемы. Фикс — добавить валидатор или расширить условие.
- Низкий precision у LLM-гипотез → поднимаем порог confidence, ниже — не показываем находку человеку. Калибровка порога идёт в приоритизацию (второй пунктир на схеме).
Без этой петли агент не становится лучше: он просто повторяет одну и ту же ошибку на всё новом объёме. С ней — precision растёт от прогона к прогону, потому что каждый FP либо чинит правило, либо сдвигает порог.
6. Выход агента: JSON + человекосводка
Финальный артефакт — два представления одних и тех же находок. Машиночитаемый JSON (для статьи 5, где перелинковка берёт findings[] как вход) и человекочитаемая сводка (для того, кто принимает решение).
{
  "generated_at": "2026-11-21T09:00:00Z",
  "site": "https://example.com",
  "summary": {
    "total_findings": 1842,
    "by_severity": {"high": 96, "medium": 540, "low": 1206},
    "precision": 0.91, "recall": 0.78,
    "top_issue": "indexed_but_error на 34 URL с суммарно 12k показов"
  },
  "findings": [
    {
      "rule": "canonical_to_redirect",
      "page_id": 104283,
      "severity": "high",
      "score": 0.83,
      "evidence": {"canonical": "https://example.com/blog/2", "canonical_status": 301},
      "explanation": {
        "why_matters": "Canonical ведёт на URL, который сам редиректит — Google может не засчитать сигнал.",
        "affected_urls": ["https://example.com/blog/1"],
        "expected_effect": "Сигнал каноникола начнёт работать после разрыва цепочки.",
        "confidence": 0.95
      }
    }
  ]
}
Человекосводка — это те же findings, отрендеренные списком «проблема → почему → какие URL → эффект», отсортированные по score. JSON идёт дальше по циклу, сводка — на экран. Одно и то же состояние, два потребителя.
👤 Зарегистрируйтесь, чтобы добавить материал в закладки.