
Статья 5 цикла «AI-агенты в техническом SEO: от MCP-серверов до автоматизации аудита». Статьи 3 и 4 дали агенту нормализованные данные и приоритизированные находки; статья 2 показала write-инструмент
apply_link, который возвращает дифф, а не применяет. Здесь эти три вещи встречаются в первом настоящем сценарии, где агент предлагает изменения на сайте: внутреннюю перелинковку.
Перелинковка — самый востребованный и самый рискованный сценарий автоматизации. Востребованный, потому что руками её делают плохо: на тысячах страниц никто не расставит осмысленные ссылки. Рискованный, потому что ошибка невидима сразу и наказывает весь сайт: переоптимизированный профиль ссылок — это фильтр, а не баг, который откатываешь одним revert. Поэтому вся архитектура ниже строится вокруг одного принципа: агент предлагает проверяемые кандидаты, решение о записи принимает человек.
1. Почему «похожесть эмбеддингов» — недостаточный сигнал
Самая наивная реализация выглядит так: эмбеддим текст каждой страницы, для целевой страницы ищем top-K ближайших по косинусу, вставляем ссылки. Это разваливается на трёх фронтах сразу, и каждый фронт — отдельный слой пайплайна.
- Семантика ≠ полезная ссылка. Две страницы могут быть почти идентичны по эмбеддингу — и быть дублями, на которые ссылаться бессмысленно. Или тематически близки, но у одной уже есть все входящие, а у другой они и не нужны.
- Эмбеддинг не знает графа. Он не видит, что между кандидатами уже есть путь в 1 хоп, и не знает, что страница orphan (статья 4 как раз нашла такие). Структурный сигнал живёт в
link-графе, а не в векторе. - Эмбеддинг не знает бизнес-правил. Нельзя ссылаться на страницы с
noindex, на канонические дубли, на страницы из стоп-листа. Это не про близость — это про допустимость.
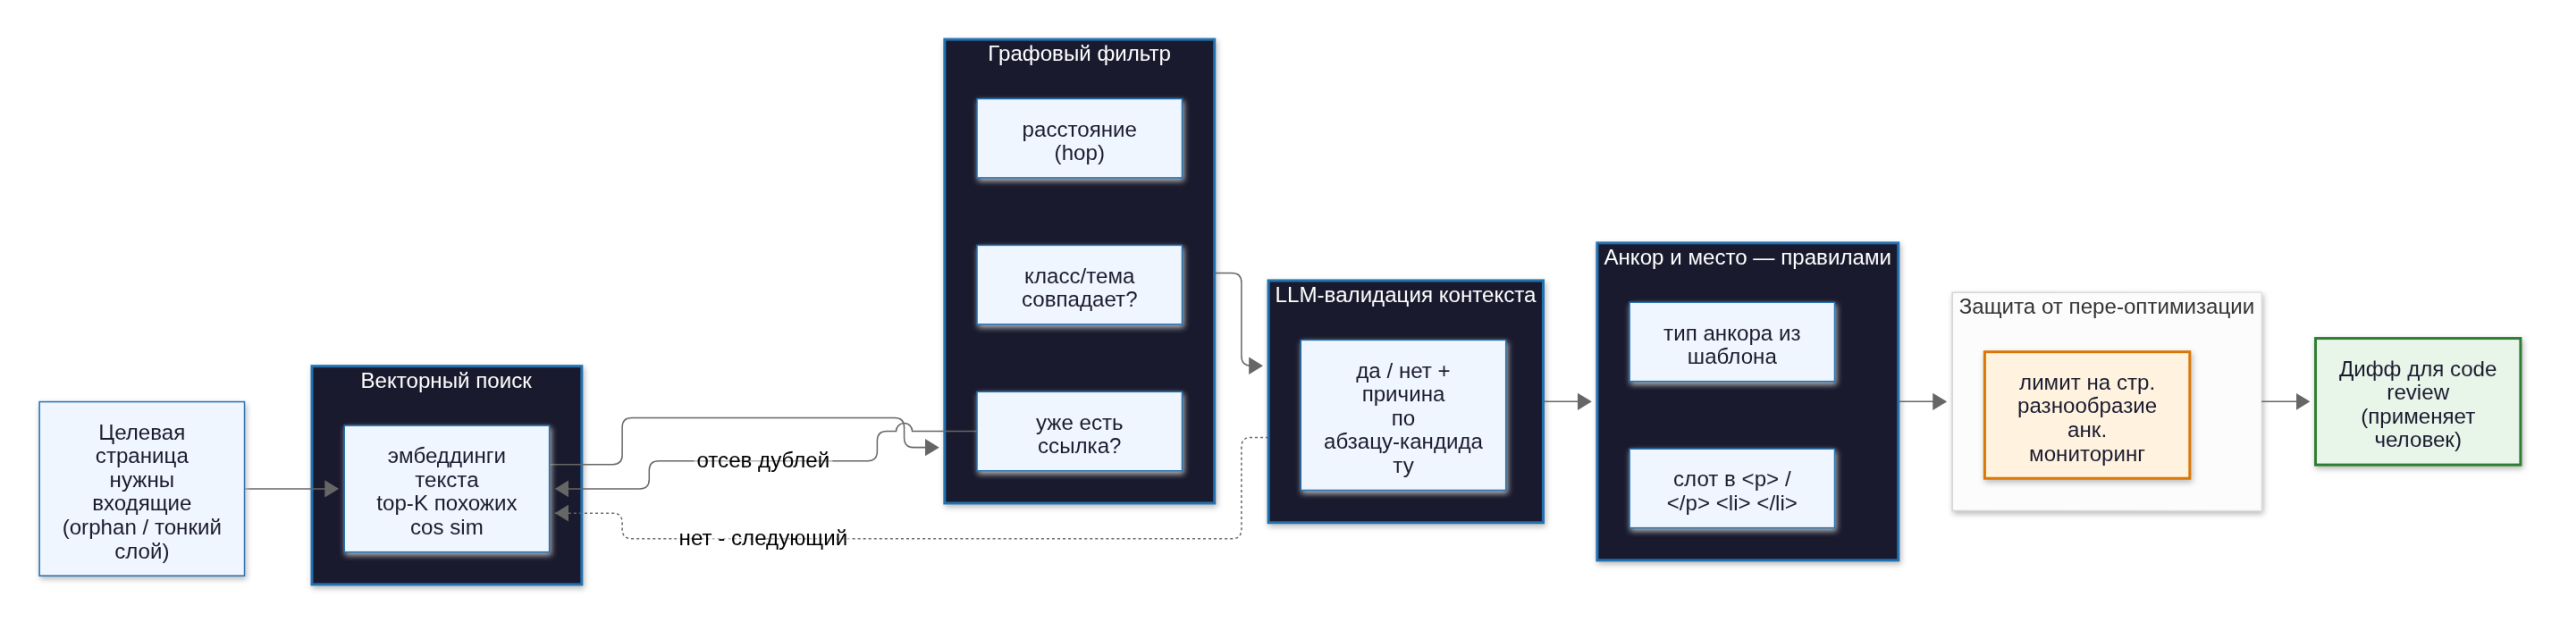
Отсюда трёхслойная архитектура: векторный поиск порождает кандидатов (это только recall, «посмотреть бы вот эти»), графовый фильтр отсекает по структуре (это precision без модели), и LLM-валидация решает, уместна ли ссылка в конкретном абзаце. Ни один слой сам по себе не годится; вместе — это проверяемое качество.
2. Кандидаты из векторного поиска
Вход — векторный индекс из статьи 3 ({page_id, embedding[], chunk}). Ищем страницы, которым нужны входящие ссылки (orphan-находки и «тонкий слой» из статьи 4), и для каждой подбираем кандидатов-доноров.
import numpy as np

def cosine(a, b) -> float:
    return float(a @ b / (np.linalg.norm(a) * np.linalg.norm(b) + 1e-9))

def vector_candidates(target_emb, index, top_k=20, min_sim=0.62) -> list:
    """Recall-этап: ближайшие по смыслу страницы-доноры.
    index: [(page_id, emb), ...]. Возвращаем НЕ финальные ссылки,
    а кандидатов на фильтрацию — поэтому порог мягкий."""
    scored = [(pid, cosine(target_emb, emb)) for pid, emb in index]
    scored = [(pid, s) for pid, s in scored if s >= min_sim]
    scored.sort(key=lambda x: x[1], reverse=True)
    return scored[:top_k]
Важная деталь: min_sim здесь низкий намеренно. Это этап recall — дешевле пропустить лишнее через дешёвый графовый фильтр дальше, чем потерять полезного кандидата на входе. Финальный отбор делает не вектор.
3. Графовый фильтр: расстояние, существующие ссылки, orphan
Кандидаты из §2 прогоняются через link-граф (таблица link из статьи 3). Три проверки, все детерминированные, ноль токенов:
def graph_filter(candidates, graph, target_id, max_hops=3) -> list:
    """Precision-этап без модели. Отсекает то, что вектор не видит."""
    kept = []
    for pid, sim in candidates:
        # 1. уже есть прямая ссылка target -> pid? дублировать нельзя
        if graph.has_edge(target_id, pid):
            continue
        # 2. слишком далеко в графе — ссылка не усилит связность
        #    (близко уже связано, вставлять нечего)
        d = graph.hops(target_id, pid)
        if d is not None and d <= 1:
            continue
        # 3. кандидат — канонический дубль или noindex? недопустим
        node = graph.node(pid)
        if node.noindex or (node.canonical_to and node.canonical_to != pid):
            continue
        kept.append((pid, sim, d))
    return kept
Третий пункт — это те самые бизнес-правила, которые эмбеддинг выразить не может. Заметьте, что orphan-статус целевой страницы сюда не входит: orphan — это причина, зачем мы вообще запустили подбор (её нашёл валидатор статьи 4), а не фильтр кандидатов.
4. LLM-валидация контекста вставки
Допустимых кандидатов мало, и каждый нужно решить по месту: уместна ли ссылка в конкретном абзаце донора. Это единственная роль LLM в пайплайне, и роль узкая — не «сгенерируй ссылку», а «скажи да/нет и причину, глядя на абзац».
Промпт-схема держит ту же дисциплину, что в статьях 2 и 4: жёсткий JSON, опора только на переданный контекст, обязательная причина и право ответить «нет».
VALIDATE_PROMPT = """
Ты валидируешь одну предполагаемую внутреннюю ссылку.
Дан: абзац-кандидат из страницы-донора и целевая страница.

РЕШИ: уместна ли ссылка на цель в этом абзаце для читателя и для SEO.
КРИТЕРИИ «нет»: цель не раскрыта в абзаце; ссылка была бы рекламной;
анкор невозможно составить естественно; это дубль цели.

ДОНОР-АБЗАЦ:
{donor_paragraph}

ЦЕЛЬ (заголовок + description):
{target_title} — {target_description}

Верни СТРОГО JSON:
{{ "verdict": "yes" | "no", "reason": "одно предложение",
   "anchor_slot": "фрагмент абзаца, куда вставить, или null" }}
Никакого текста вне JSON.
"""

def llm_validate(donor_para, target, call_llm) -> dict:
    raw = call_llm(VALIDATE_PROMPT.format(
        donor_paragraph=donor_para,
        target_title=target.title,
        target_description=target.desc))
    v = parse_json(raw)                       # жёсткая схема -> парсится
    if v.get("verdict") != "yes" or not v.get("anchor_slot"):
        return {"ok": False, "reason": v.get("reason", "no")}
    return {"ok": True, "slot": v["anchor_slot"], "reason": v["reason"]}
Ключевой момент: verdict: "no" — это нормальный и ожидаемый ответ, а не сбой. Модель стоит на позиции «фильтр по уместности», и её отказ дешевле, чем ложная ссылка, которую потом ловит человек на code review.
5. Анкор и место — правилами, а не свободной генерацией
Самая частая ошибка агентных перелинковщиков — позволить модели свободно сочинять анкор. Это прямой путь к переоптимизации: модель любит «точное вхождение», а спам точными вхождениями — классический сигнал Penguin-класса. Поэтому анкор и слот задаёт код по шаблону, а модель лишь указывает слот.
ANCHOR_TEMPLATES = {
    "exact":      lambda t: t.title,                 # <5% ссылок
    "partial":    lambda t: t.title.split(":")[0],   # ядро темы
    "brand_url":  lambda t: t.domain,                # домен/бренд
    "natural":    lambda t: t.anchor_hint,           # из description, короче
    "generic":    lambda t: "подробнее",             # без ключа
}

# Целевое разнообразие анкоров (доля по типу) — анти-переоптимизация
ANCHOR_MIX = {"exact": 0.05, "partial": 0.35, "brand_url": 0.15,
              "natural": 0.35, "generic": 0.10}

def pick_anchor(target, used_counts) -> str:
    """Выбирает тип анкора так, чтобы профиль вставляемых ссылок
    тянулся к ANCHOR_MIX, а не к одному типу."""
    total = sum(used_counts.values()) or 1
    # тип, который сильнее всего отстаёт от целевой доли
    deficit = {k: ANCHOR_MIX[k] - used_counts.get(k, 0)/total for k in ANCHOR_MIX}
    chosen = max(deficit, key=deficit.get)
    return ANCHOR_TEMPLATES[chosen](target), chosen
Место вставки — слот из §4 (anchor_slot), обёрнутый в <a>. Никакой генерации нового текста абзаца: агент вставляет ссылку в существующую фразу, а не переписывает страницу. Это и граница риска, и то, что делает дифф маленьким и ревьюибельным.
6. Как не скатить сайт в переоптимизацию: лимиты, разнообразие, мониторинг
Перелинковка опасна не отдельной ссылкой, а распределением. Поэтому три механизма защиты встроены в пайплайн, а не «на потом»:
- Лимит на страницу. Не более N новых ссылок на страницу за прогон (например, 3) и общий бюджет на сайт. Иначе агент за вечер удваивает плотность ссылок.
- Разнообразие анкоров.
pick_anchorиз §5 следит за профилем долей (ANCHOR_MIX), не давая «точному вхождению» занять больше 5%. - Мониторинг после деплоя. Профиль анкоров и распределение PageRank-подобной центральности смотрятся до/после; резкий сдвиг — сигнал откатить партию. Это уже территория статьи 6, но счётчик закладывается здесь.
def enforce_limits(proposals, per_page=3, site_budget=200):
    by_page = {}
    out = []
    for p in proposals:
        by_page[p.target_id] = by_page.get(p.target_id, 0) + 1
        if by_page[p.target_id] > per_page:
            continue
        if len(out) >= site_budget:
            break
        out.append(p)
    return out
7. Дифф для code review и чек-лист перед деплоем
Выход пайплайна — не запись, а предложение в форме диффа, ровно как apply_link из статьи 2 возвращал {"diff": ..., "applied": false}. Человек читает контекст и решает.
--- a/pages/blog/nginx-tuning.html
+++ b/pages/blog/nginx-tuning.html
@@ абзац про keepalive @@
- Настройка keepalive зависит от числа воркеров.
+ Настройка <a href="/blog/worker-processes">числа воркеров Nginx</a>
+ влияет на keepalive-соединения.
   <!-- link-proposal: target=/blog/worker-processes
        anchor_type=partial verdict=yes reason="абзац прямо про воркеры"
        confidence=0.88 batch=2026-11-21 -->
Комментарий-метаданные в диффе — чтобы ревьюер видел почему агент предложил именно это (вердикт, причину, уверенность, партию), не лезя в логи.
Чек-лист перед деплоем партии (короткий, потому что он про безопасность, а не про красоту):
- Все ссылки ведут на индексируемые не-дубли страницы (фильтр §3 не подвёл).
- Профиль анкоров партии в пределах
ANCHOR_MIX(нет всплеска точных вхождений). - Ни одна страница не получила больше
per_pageновых ссылок. - Каждый дифф просмотрен человеком; нет автоприменения без утверждения.
- Зафиксирован снимок «до» (плотность ссылок, профиль анкоров) для мониторинга после.
- Есть путь отката партии (метка
batch=...позволяет снять одним прогоном).
👤 Зарегистрируйтесь, чтобы добавить материал в закладки.